피싱 문자 탐지 — 모델부터 서비스까지
KoBERT 분류기와 SBERT 오탐 임베딩 뱅크를 결합해, 놓치면 안 되는 쪽으로 설계한 탐지 시스템
- 피싱은 전체의 1.4%뿐이었습니다. 이 정도 불균형에서는 '전부 정상'이라고만 답해도 정확도가 98.6%가 나옵니다.
- 평가 기준을 Recall로 바꾸고, KoBERT가 놓친 사례를 SBERT 임베딩 뱅크로 쌓아 2차 방어막을 만들었습니다.
- Test Recall 0.9672 / Precision 0.9077을 달성하고 웹으로 배포했으며, 교내 해커톤에서 대상을 받았습니다.
문제 🤔
피싱 데이터는 전체의 1.4%뿐이었습니다. 이 정도 불균형에서는 모델이 '전부 정상'이라고만 답해도 정확도가 98.6%가 나옵니다. 정확도로 모델을 고르면 아무것도 탐지하지 않는 모델이 1등이 됩니다.
접근 🛠
- 평가 기준을 정확도가 아니라 Recall 중심으로 바꾸고, 클래스 가중치를
35.13으로 설계했습니다. 4단계 Stratified 분할로 각 분할의 클래스 비율을 유지했습니다.- KoBERT 예측만으로는 변종을 놓친다고 보고,
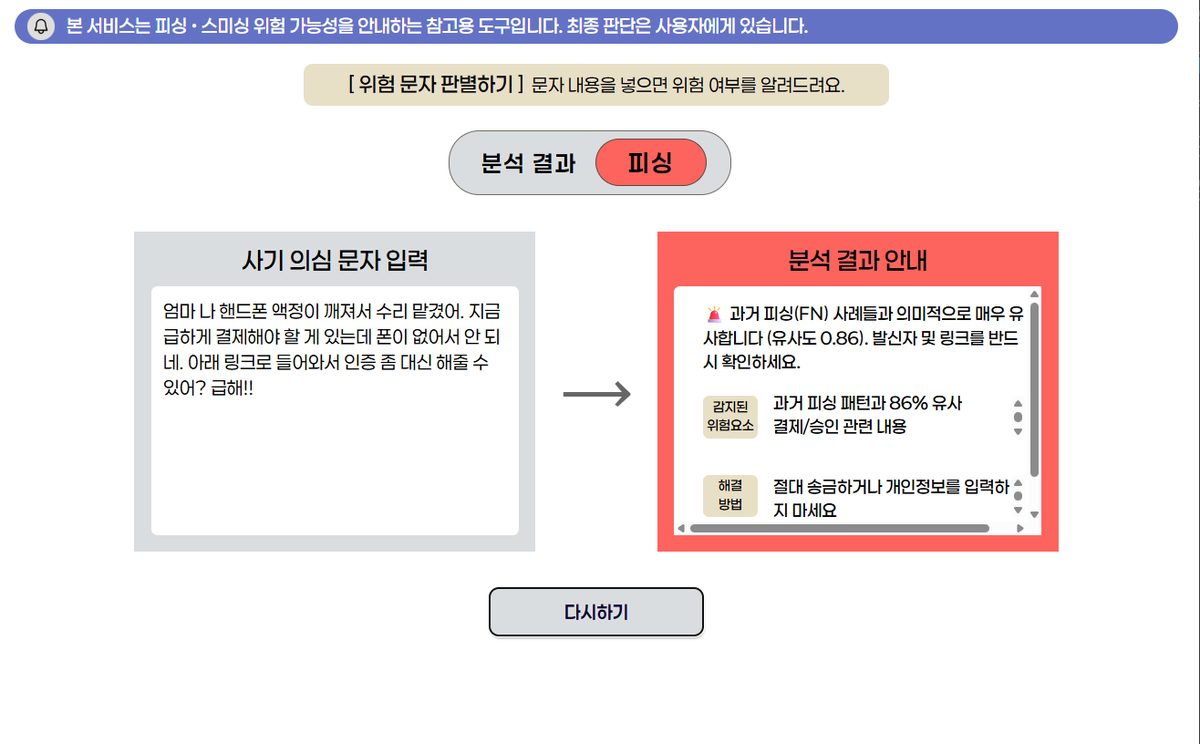
SBERT 오탐(FN) 임베딩 뱅크를 2차 방어막으로 구축했습니다. - 1차에서 정상으로 분류돼도 뱅크와의 유사도가 0.80 이상이면 의심 피싱으로 승격시켰습니다.
- 여기서 멈추지 않고 Django 웹 서비스(SilverGuard)로 확장해, 사용자가 문자를 넣으면 위험도와 대응 지침을 받는 형태까지 만들었습니다.
- 무거운 모델을 서빙하기 위해 싱글톤 로딩을 적용하고 검사 이력을 세션 기반으로 관리했습니다.
결과 📈
Test Recall 0.9672 / Precision 0.9077을 달성했고, 웹 서비스로 배포해 실제로 문자를 넣어볼 수 있는 형태까지 완성했습니다. 교내 해커톤에서 대상을 받았습니다. 이후 같은 모델을 Django 웹 서비스(SilverGuard)로 확장해 API 응답 시간을 80% 이상 단축했습니다. 모델을 만드는 데서 끝내지 않고 사람이 실제로 쓰는 형태까지 끌고 간 프로젝트입니다.
이 프로젝트에서 제가 한 것 ✍
- KoBERT 분류기 학습 — 클래스 가중치 35.13 설계, 4단계 Stratified 분할
- SBERT 오탐(FN) 임베딩 뱅크 구축 및 유사도 0.80 승격 로직 설계
- 평가 기준을 정확도에서 Recall 중심으로 전환하고 임계값 결정
- 학습·검증 노트북 분리로 검증 오염 차단
- 웹 서비스(SilverGuard) 확장 시 NLP 모델 튜닝과 탐지 알고리즘 설계 담당
금융 직무와의 연결 🎯
- 이상탐지 · 보안 — 1.4% 비율의 극단적 불균형에서 가중치와 계층 분할로 학습을 안정화했습니다. FDS의 사기 거래 비율과 같은 조건입니다.
- 비용 기반 임계값 — 임계값을 통계가 아니라 미탐 손실 비용으로 결정했습니다. 금융 사기탐지의 판단 구조와 동일합니다.
- 디지털 · 데이터 — 모델을 Django로 서빙하며 싱글톤 로딩으로 API 응답을 80% 이상 단축하고, 370MB 가중치를 동적 로드로 처리했습니다.
기술 선택과 판단 근거 🧭
왜 그 방법을 택했는지, 무엇을 택하지 않았는지 적었습니다.
텍스트 증강과 오버샘플링을 쓰지 않았다
한국어 텍스트 증강은 현실에 없는 어색한 문장을 만들어 노이즈가 될 위험이 컸습니다. 해커톤 시간 제약도 있어 가중치 조절 + 2차 검증이라는 더 안전한 경로를 택했습니다.
KoBERT와 SBERT의 역할을 나눴다
KoBERT는 단어·문맥 단위 표현이라 분류에 강하고, SBERT는 문장 전체를 벡터로 만들어 의미적 유사도 비교에 특화돼 있습니다. 같은 모델을 두 번 쓰는 대신 성질이 다른 둘을 직렬로 걸었습니다.
Recall만 올리지 않았다
Recall만 극대화하면 정상 문자까지 차단해 사용자가 서비스를 꺼버립니다. Precision 0.9077을 함께 유지하는 지점을 임계값으로 잡았습니다.
더 자세히
관심 있는 항목만 펼쳐 보세요.
이 프로젝트가 시작된 배경
노년층을 노린 피싱 문자는 계속 표현을 바꿔 가며 들어옵니다. 서비스 대상이 노년층이라 미탐 한 건의 비용이 오탐 한 건보다 훨씬 컸습니다.
기술 판단 더 보기 3
모델을 요청마다 로드하지 않고 한 번만 메모리에 올렸다
웹 서비스에서 요청이 올 때마다 모델을 로드하면 응답이 느려집니다. Django AppConfig.ready()에서 구동 시 한 번만 로드해 전역에 상주시키는 싱글톤 방식으로 바꿨고, 로드 오버헤드가 사라져 API 응답 시간이 80% 이상 단축됐습니다.
370MB 모델을 저장소에 넣지 않고 실행 시 내려받게 했다
모델 가중치가 약 370MB라 GitHub 용량 제한에 걸립니다. 저장소를 무겁게 만드는 대신 gdown으로 클라우드에서 실행 시점에 내려받는 로더를 만들었습니다. 저장소는 가볍게 유지되고 배포는 그대로 됩니다.
로그인 없이도 검사 이력을 남기게 했다
고령층 대상 서비스라 회원가입 자체가 진입 장벽입니다. 브라우저 세션 키를 식별자로 써서 로그인 없이 최근 검사 기록 20건을 볼 수 있게 했습니다.
막혔던 지점과 해결 과정 3
정확도를 기준으로 잡으면 아무것도 못 잡는다
피싱이 1.4%인 데이터에서는 전부 정상이라고 답해도 정확도 98.6%가 나옵니다. 평가 기준을 Recall 중심으로 바꾸고, 클래스 가중치 35.13으로 소수 클래스의 오답에 더 큰 벌점을 줬습니다.
모델을 키우는 대신 2차 방어막을 붙였다
KoBERT가 놓치는 건 대부분 표현만 살짝 바꾼 변종이었습니다. 더 큰 모델을 쓰는 대신, 놓친 사례(FN) 자체를 SBERT로 임베딩해 뱅크로 쌓고 유사도 0.80 이상이면 의심으로 승격시켰습니다. 놓친 사례가 쌓일수록 방어막이 두꺼워지는 구조입니다.
과적합이 아니라는 근거를 준비했다
가중치를 35배나 준 모델은 과적합을 의심받습니다. 과적합이었다면 소수 클래스에 과반응해 Precision이 같이 무너졌을 것인데 0.9077을 유지했고, 학습셋이 아닌 Test셋에서 나온 수치라는 점을 함께 제시했습니다.
데이터
이 결과가 틀렸을 수 있는 지점
- 임계값 0.80은 검증셋 기준으로 고른 값이라 실제 트래픽 분포에서는 재조정이 필요합니다.
- FN 뱅크는 놓친 사례가 쌓여야 효과가 커지는 구조라 초기에는 방어막이 얇습니다.
- 텍스트만 처리합니다. 이미지 속 URL을 읽는 OCR을 붙이면 더 넓은 스미싱을 막을 수 있습니다.
- 텍스트만 처리합니다. 이미지 속 URL을 읽는 OCR을 붙이면 더 넓은 스미싱을 막을 수 있습니다.
금융 직무 연결 더 보기
- 2차 방어막 설계 — 단일 모델에 의존하지 않고 룰 · 유사도 필터를 직렬로 배치했습니다. 실제 FDS 아키텍처의 방식입니다.
회고
이상탐지에서 임계값은 통계가 아니라 비용의 문제라는 것을 배웠습니다. 금융의 이상거래탐지(FDS)도 같은 구조의 판단을 요구한다고 생각합니다.